
高性能计算机的各种应用
当前,仿真软件在建模及各类相关功能上已日趋成熟,为用户提供了诸多便利。用户可通过自行绘制场景模型或导入CAD文件的方式进行建模,设定材料参数与计算条件后即可运行仿真。在用户界面日益完善及操作系统更加人性化的辅助下,这些操作正变得越来越简单。
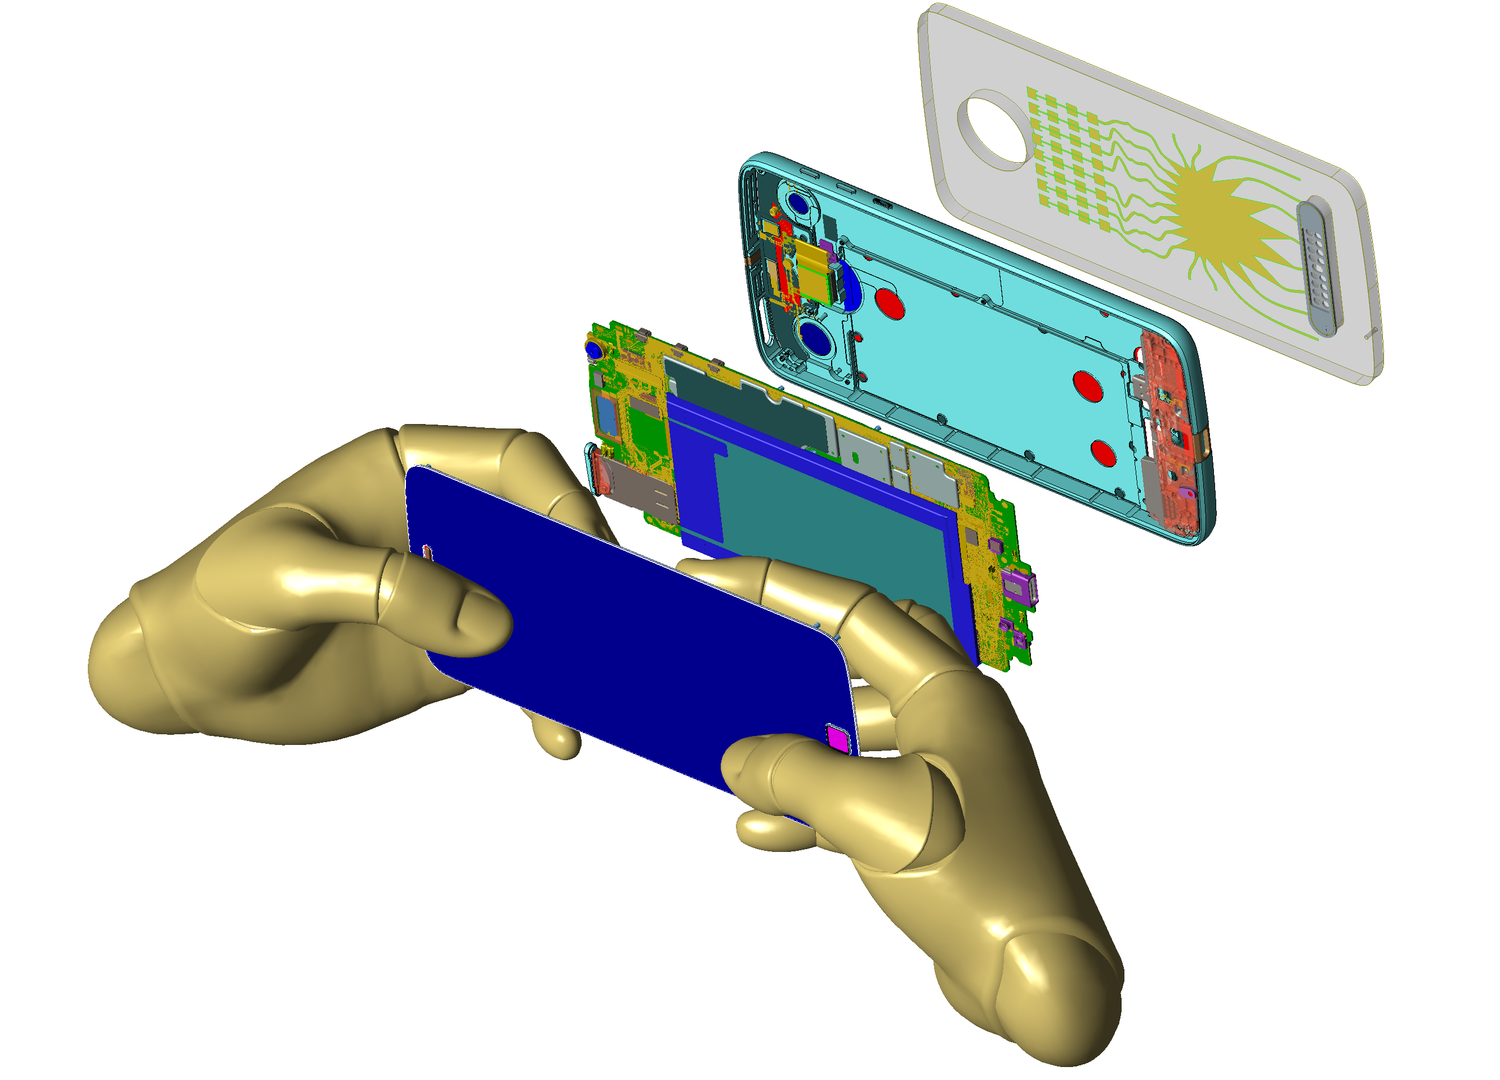
然而,仿真仍然高度依赖硬件资源与算力支持。建模完成后,仿真软件需对场景模型进行处理,并将全部或部分数据存放于主板内存,随后调用CPU或GPU执行算法模型。建模场景、几何结构、材料参数及计算条件等均作为模型输入参数导入,并交由CPU或GPU计算。计算过程中,输出数据暂存于显存或内存,待计算结束后再写入硬盘,固定为最终仿真结果。
在这一过程中,所调用的算力资源包括主板内存、CPU、GPU、显存及硬盘。影响效能的因素则涵盖CPU或GPU的性能、CPU核心数或线程数、显存与内存容量、内存与显存的主频及带宽,以及数据写入硬盘时的读写速度等,所有这些因素共同累积,最终影响整体仿真效率。
因此,当前用户在为仿真软件配置高性能硬件时,通常会依据软件特性及自身需求进行选择。例如,支持GPU加速的仿真软件,用户需考虑购置GPU;支持多核心多线程并行处理的软件,则需考量增加CPU线程数与核心数。同时,还需评估软件运行是否会额外占用内存或显存等问题,只有在综合考虑这些条件后,才能搭配出既满足需求又具经济效益的计算平台。
仿真规模与精度要求同步提升
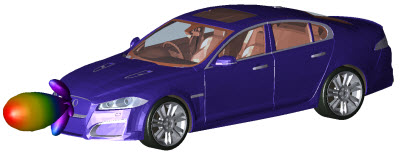
在二十世纪九十年代仿真软件发展初期,由于计算机软硬件尚不成熟,建模难度远高于今日,仿真所能考量的物理量及输出类型均十分有限,硬件性能也远不及当前水平。因此,当时的仿真软件多用于处理较为简单的问题,通常仅提供指示性输出,且缺乏完善的指南或教材。用户往往仅能获取极为简略的学习材料,需耗费大量时间自行摸索。因而,仿真软件普遍存在“不好用、不精确、不够快”的问题,甚至有用户完全放弃商用软件,转而使用C语言或MATLAB等工具自行编写代码进行仿真。这种方式虽对熟悉编程的用户较为便利,但软件功能极为受限,应用范围狭窄,输出类型少,建模尤为困难,且结果无法可视化呈现,仅能以数据形式输出。时至今日,这种工作方式仍难以克服上述问题。好比一位做包子的师傅,若要自行种麦、养猪、种菜,再以此制作包子,而不去采购现成的面粉、蔬菜和肉类,虽在学术研究中因教育考量尚具一定合理性,但在产业应用中,要求在有限时间内提供有意义成果并控制合理成本,这种“为做包子而种小麦”的模式显然行不通。
更为重要的是,在严肃的工业应用中,必须充分考虑验证与确认(Verification and Validation)的问题,即所产出数据、使用方法和代码均需经过严格验证,不仅需对比输出结果,还需确保代码与软件本身无缺陷,能够稳定提供正确的输出。而上述“自给自足”的方式,难以通过此类验证,从而为商业产品带来潜在风险,因为企业需要的是一个可靠工具,而非自行开发工具,而这类自建工具往往也不具重复使用价值。因此,在商业领域,此类做法并不划算。
如今,商用仿真软件已较过去成熟许多,用户获取参考资料、文档或视频培训材料的途径也更加丰富,因而对仿真软件的使用要求也随之提高。这通常表现为两个方向:一方面,用户对仿真精度的要求不断提升,但对建模的便利性要求同样增强——即用户希望以更简便的方式构建高精度输出模型。这不仅对用户界面及软件功能提出更高要求,高精度计算本身亦受限于几何结构细节、网格尺寸缩小以及电磁仿真频率提高等因素,对CPU或GPU的算力需求也随之增加,甚至单颗处理器难以在合理时间内输出满足精度要求的结果。另一方面,计算规模持续扩大,部分仿真并非仅针对单一元器件(如天线)的设计,而是探讨某一环境内在特定条件下电磁或力学物理现象的变化。元器件或终端产品的空间尺度通常在二三十公分左右,而环境尺度则可能达数公里至数十公里。环境内的地形、建筑物等需尽量保留对物理量变化影响较大的特征,进行较精确的建模,甚至需考虑河流、海面等特殊地形。此类大型场景亦可能需进行网格剖分等前处理,这将占用大量显存或内存;同时,随着仿真推进,射线追踪算法的路径数量亦不断增加,对内存和显存的占用会进一步上升。因此,用户必须考虑配备充足的显存或内存,否则仿真可能无法进行,虚拟实验设计也需重新调整。
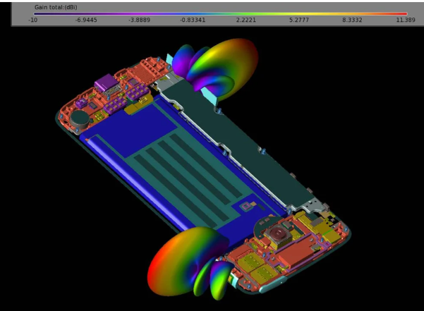
以我们的仿真软件为例,如Xfdtd,大量计算工作交由GPU执行,网格数据直接存放于显存中,CPU与主板内存主要负责后处理、软件界面操作及基本运行,同时充当数据写入硬盘时的中转。因此,硬件需求主要集中于GPU。若单张GPU显存不足,需插接两张同型号GPU,合并其显存,方能满足用户仿真需求。当信号频率提高、几何细节尺寸缩小,网格尺寸需相应减小,网格数量增多,显存占用也随之增加。因此,用户可开展的仿真规模及输出精度,直接受限于可用显存容量。
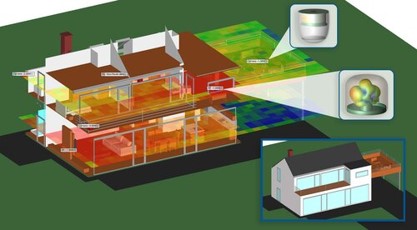
而另一款仿真软件Wireless Insight则刚好相反。该软件同样使用GPU,但GPU的性能差异在仿真中的体现相对有限——高端GPU与普通游戏卡之间的计算差距并不显著。用户额外投入十几万元购置的高端算卡,可能仅比一张万元级游戏卡快十几秒;若仿真任务较为简单,两者耗时甚至只差几秒。反之,传播路径的主要计算由CPU与主板内存承担,因此CPU线程数决定仿真效能,而主板内存容量则决定用户可仿真规模及结果分辨率与精细程度。
分布式计算
随着技术进步,当前硬件性能已远超九十年代,操作系统亦更加便利。用户对仿真软件的工作要求也愈加繁重复杂,精度与模型尺度要求同步提高。最终,不仅需增加CPU线程数、大量主板内存,可能还需在单台服务器上插接多张显卡,方可满足用户仿真需求。
然而,单块主板的承载能力有限,其提供的CPU、内存及GPU插槽数量均有上限。即便插满内存,亦不一定满足用户需求;同样,插满GPU也不一定能提供足够的算力或显存。同时,机箱或机柜内电源供应器空间有限,未必能提供充足电力驱动这些硬件,尤其是CPU与GPU功耗较大。即便电源满足需求,稳定性与散热亦会构成严重问题。因此,将所有算力集中于单台服务器,不仅受限于主板支持能力,稳定运行与安全性亦难以保障。
在此情况下,需将系统化整为零,构建分布式系统,即集群。通过部署两台或更多配置完全相同的服务器,并将其整合至小型或中型局域网中,可将各服务器资源汇聚为资源池。例如,若每台服务器配备四张GPU,四台服务器即可提供十六张GPU;若每台提供128个CPU线程,四台即可提供512个线程;若每台内存为2TB,四台合计8TB。用户可根据预算灵活扩展集群,并通过软件将仿真任务进行拆分,分配至各节点调用资源并行计算。以Xfdtd为例,若需进行太赫兹频率仿真,需80GB以上显存,而单台服务器显存总量不足,用户只能新增GPU或更换更高配置服务器。若拥有集群,则可将计算任务拆分为两块,分别指派至两台服务器同步计算,同时调用两者的GPU与显存,从而完成单机无法实现的任务。
另一方面,若某仿真工作需40GB显存,虽可在一台服务器上完成,但若拆分为两块,在两个集群节点上同步执行,则单个节点负载显著降低,效能提高;同时,两个节点可提供更多CPU线程,便于处理非GPU部分,主板亦提供双倍内存,使数据读写更高效。这如同“两个和尚抬水喝”,有助于提升仿真效能。具体提升幅度因软件优化程度而异,但总体而言,仿真计算越繁重,分布式计算所带来的效能提升通常越显著。
因此,具备分布式计算能力的集群可在两方面发挥作用:其一,使单机无法实现的工作成为可能;其二,将大规模计算任务拆解为更易处理的小块,提高仿真效能。
此外,从维护角度看,GPU及内存经长时间高强度使用后可能损坏,需及时更换。集群的优势在于,用户可使用性价比较高的GPU或CPU构建庞大资源池,即便其中某一节点硬件故障,也仅需更换对应部件,节点下线亦不影响集群整体运行。因此,维护成本更易控制,使用更加灵活,不会像单机服务器那样,一旦故障整机停摆,工作被迫中断。
我公司与云轩品牌在专业项目上拥有愉快的合作经验。我们的合作伙伴以合理实惠的价格提供基于用户需求定制的服务器与集群,并提供充分的技术支持。我们将携手合作伙伴,在本地面向专业用户提供优质高端计算设备,同时面向海外市场推广合作伙伴的优质产品。